
Libre Lac de données pour un Cloud Native World

Deploy Apache Spark on Kubernetes in minutes with your fully managed platform.

$curl -fsSL https://get.ilum.cloud/cli | bash
Profitez de toutes nos fonctionnalités sur Pas de frais. A unified data lakehouse platform for data analytics and AI. One platform to manage all your données workflows – Plus rapide, plus facile et plus gratuit.
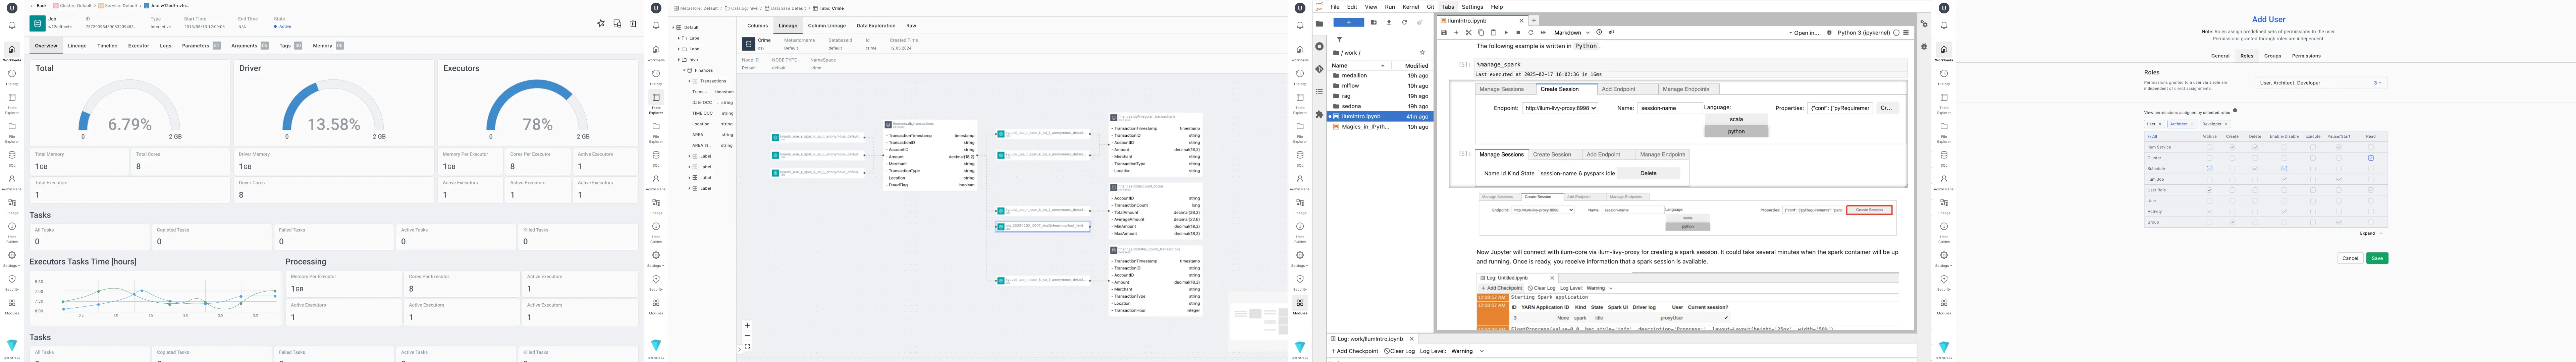
Ilum Data Lakehouse Dashboard Screenshots showing Spark Cluster Management
Exploration des données

Exploration des données

Gestion multi-cluster

Gestion multi-cluster

Traçabilité automatisée des données

Traçabilité automatisée des données

Entreprises utilisant ilum

Plus de 200 équipes de données débloquent déjà des informations grâce à

Géré Lac de données pour Quelconque Déploiement

Ouvrir la flexibilité de la Plateforme Managed Data Lakehouse, conçu pour être déployé dans Environnements sur site, cloud ou hybrides. Our modern data lakehouse architecture combines the flexibility of data lakes with the speed of warehouses – Ilum gives you both, offering a complete Spark sur Kubernetes solution without the cost.

Le pouvoir de personnaliser votre plateforme de données

Ilum vous permet de choisir les outils qui conviennent le mieux à votre flux de travail, qu’il s’agisse de Lac Delta, Apache Icebergou Apache Hudi.

Vous n’êtes pas enfermé dans un seul Outil BI ou Carnet de notes. Connectez-vous avec PowerBI, Tableau, ou utilisez nos modules intégrés tels que Sur-ensemble.

Que vous souhaitiez intégrer avec Flux d’air Apache Pour l’orchestration, exécutez l’analyse exploratoire dans Jupyter, ou tirez parti d’outils de ML comme MLflow pour vos pipelines d’apprentissage automatique, Ilum soutient tout.

Avec Ilum, vous gardez le contrôle total pour construire un écosystème de données qui correspond parfaitement à vos besoins.

Explorez notre écosystème
Kubernetes natif

Kubernetes natif

Tirez parti de la Évolutivité et robustesse de Kubernetes sans avoir à le configurer manuellement.
Stockage flexible

Stockage flexible

Connectez-vous à l’interface S3 intégrée ou utilisez : Amazon S3, Stockage Azure, Google Cloud Storage, HDFS.
Quelque part

Quelque part

Déployez Ilum n’importe où, que ce soit sur le nuage, sur site, ou un hybride environnement, vous offrant une flexibilité ultime dans le déploiement.

Managed Spark Cluster on Kubernetes

Tired of the complexity of Hadoop or Cloudera? Ilum delivers the power of Apache Spark and Airflow without the headache, offering a seamless cloud-native data platform alternative.


Managing a Spark Cluster can be challenging, but Ilum makes it straightforward. We handle the hard part of Kubernetes Spark operator management, allowing you to focus on extracting Des informations à partir de vos données.

Avec Kubernetes at its core, Ilum automates spark cluster provisioning, scales resources dynamically based on workload demands, and ensures high availability for your big data workloads.


Ilum is not just a platform for managing and monitoring Apache Spark on Kubernetes. It also serves as your own fully managed Spark cluster and Data Lakehouse.
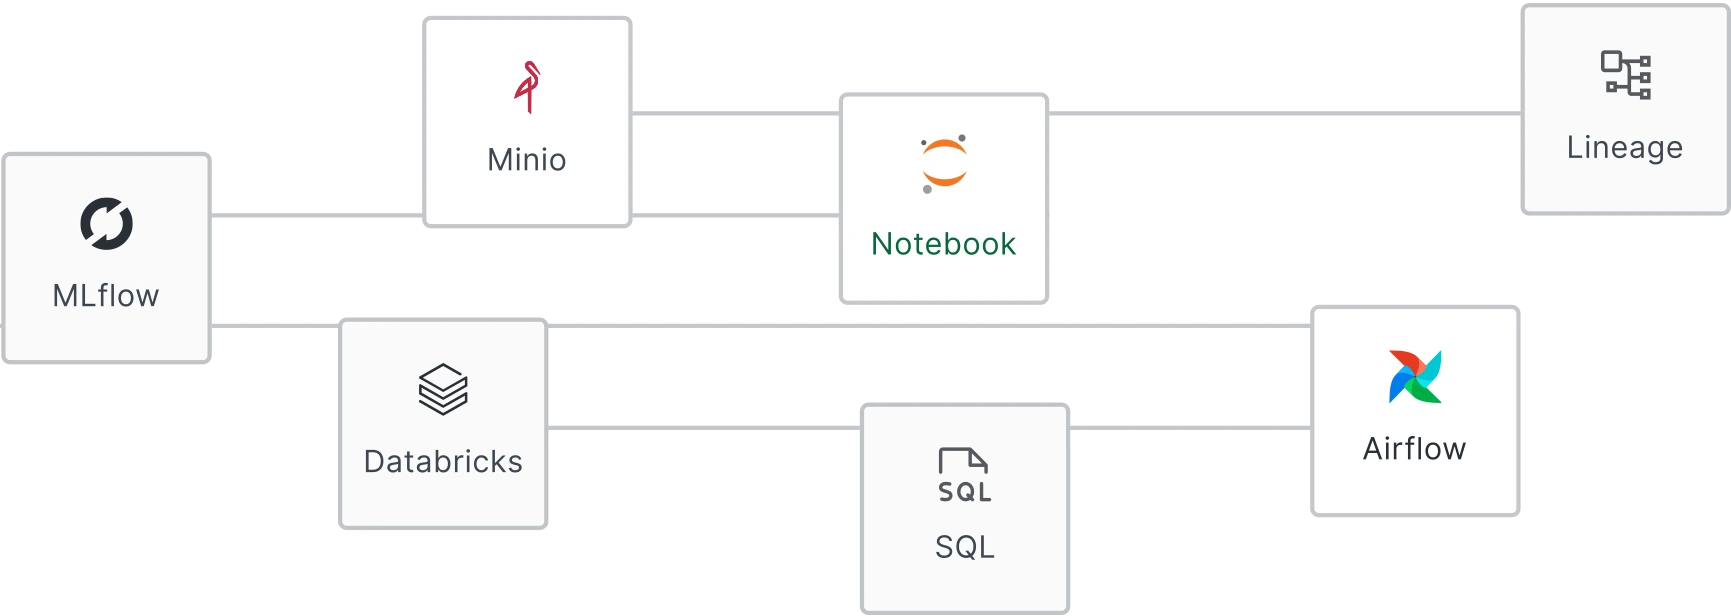
Ilum Data Lakehouse Tech Stack showing Apache Spark, Kubernetes and Airflow

L’observabilité à vos mains

Éliminez les conjectures dans le débogage avec les journaux et les métriques détaillés d’Ilum. Plongez facilement dans les journaux Spark et les métriques de performance, le tout en un seul endroit, ce qui simplifie identifier les goulets d’étranglement et des problèmes qui sont souvent difficiles à retracer dans des environnements standard.

Débogage et surveillance avec Ilum

Ilum fournit un Environnement unifié pour surveiller vos tâches Spark à l’aide de journaux détaillés et de mesures de performances. Alors que les environnements traditionnels rendent difficile l’accès aux journaux et aux métriques en un seul endroit, Ilum Simplifie ce processus, permettant aux développeurs de se plonger dans les journaux et les métriques Spark sans passer d’un outil à l’autre.

En offrant Accès centralisé aux journaux clés et aux mesures de performance en temps réel, les développeurs peuvent rapidement Goulets d’étranglement précis, de suivre les erreurs et d’optimiser les tâches Spark. Il fournit les informations essentielles nécessaires pour résoudre les problèmes plus rapidement et améliorez les performances du cluster.

Cette approche simplifiée Améliore la productivité en gardant à portée de main les ressources de surveillance vitales, ce qui facilite la gestion et le dépannage de votre environnement Spark.

Obtenez-le gratuitement

Technologies utilisées dans l’ilum

Vous avez des idées pour améliorer Ilum ?

Nous apprécions vos commentaires et sommes toujours désireux de nous améliorer. Si vous avez des suggestions qui pourraient améliorer votre expérience ou faciliter la navigation dans le produit, n’hésitez pas à nous le faire savoir. Rejoignez-nous pour façonner l’avenir de notre plateforme ! Votre contribution compte.

Ajouter une demande de fonctionnalité

Sessions interactives alias Spark Microservices

Éliminez jusqu’à 99% du temps qui serait normalement consacré à l’initialisation d’un travail Spark.
Contrôlez une session Spark via l’API REST et créez une interaction en temps réel avec un cluster Spark.

SparkPi avec spark-submit sur fil 50 secondes

SparkPi interactif avec API Ilum sur kubernetes 1 seconde

Peu importe si votre configuration Spark
Utilise Fil Hadoop ou Kubernetes

Déploiement multi-environnements

Ilum prend en charge le déploiement dans les environnements cloud et sur site, offrant la flexibilité nécessaire pour exécuter des clusters Spark partout où votre infrastructure l’exige.

Soutien à la migration

Passez facilement de systèmes hérités tels que Hadoop à des architectures modernes et natives du cloud grâce aux capacités de migration intégrées d’Ilum, minimisant ainsi les temps d’arrêt et la complexité.

Intégration de Kubernetes et Hadoop Yarn

Que vous utilisiez Kubernetes pour l’orchestration de conteneurs ou Hadoop Yarn pour la gestion des ressources, Ilum s’intègre de manière transparente aux deux, garantissant ainsi des opérations fluides dans n’importe quelle configuration.

Compatibilité et flexibilité

Ilum est conçu pour être adaptable, offrant une compatibilité avec divers systèmes et outils de stockage, garantissant que vos clusters Spark fonctionnent efficacement, quelle que soit votre pile technologique.

Play Ilum Product Demo Video

Nous pouvons vous aider à prendre un bon départ

Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Des outils comme Ilum contribueront grandement à simplifier le processus d’installation d’Apache Spark sur Kubernetes...

Lire l’article
Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Salutations aux passionnés d’Ilum et aux fans de Python ! Nous sommes ravis de dévoiler une nouvelle fonctionnalité très attendue qui devrait donner...

Lire l’article
Qu’est-ce qu’un Data Lakehouse ?

Qu’est-ce qu’un Data Lakehouse ?

Explorez le concept de la data lakehouse, une approche moderne de la gestion des données qui combine les avantages de ...

Lire l’article
Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Il existe trois types de tâches que vous pouvez exécuter dans Ilum : la tâche unique, la tâche interactive et le code interactif...

Lire l’article
Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Des outils comme Ilum contribueront grandement à simplifier le processus d’installation d’Apache Spark sur Kubernetes...

Lire l’article
Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Salutations aux passionnés d’Ilum et aux fans de Python ! Nous sommes ravis de dévoiler une nouvelle fonctionnalité très attendue qui devrait donner...

Lire l’article
Qu’est-ce qu’un Data Lakehouse ?

Qu’est-ce qu’un Data Lakehouse ?

Explorez le concept de la data lakehouse, une approche moderne de la gestion des données qui combine les avantages de ...

Lire l’article
Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Il existe trois types de tâches que vous pouvez exécuter dans Ilum : la tâche unique, la tâche interactive et le code interactif...

Lire l’article
Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Des outils comme Ilum contribueront grandement à simplifier le processus d’installation d’Apache Spark sur Kubernetes...

Lire l’article
Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Salutations aux passionnés d’Ilum et aux fans de Python ! Nous sommes ravis de dévoiler une nouvelle fonctionnalité très attendue qui devrait donner...

Lire l’article
Qu’est-ce qu’un Data Lakehouse ?

Qu’est-ce qu’un Data Lakehouse ?

Explorez le concept de la data lakehouse, une approche moderne de la gestion des données qui combine les avantages de ...

Lire l’article
Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Il existe trois types de tâches que vous pouvez exécuter dans Ilum : la tâche unique, la tâche interactive et le code interactif...

Lire l’article
Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Comment exécuter Apache Spark sur Kubernetes en moins de 5 minutes

Des outils comme Ilum contribueront grandement à simplifier le processus d’installation d’Apache Spark sur Kubernetes...

Lire l’article
Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Déploiement de PySpark Microservice sur Kubernetes : révolutionner les lacs de données avec Ilum.

Salutations aux passionnés d’Ilum et aux fans de Python ! Nous sommes ravis de dévoiler une nouvelle fonctionnalité très attendue qui devrait donner...

Lire l’article
Qu’est-ce qu’un Data Lakehouse ?

Qu’est-ce qu’un Data Lakehouse ?

Explorez le concept de la data lakehouse, une approche moderne de la gestion des données qui combine les avantages de ...

Lire l’article
Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Comment optimiser votre cluster Spark avec des travaux Spark interactifs

Il existe trois types de tâches que vous pouvez exécuter dans Ilum : la tâche unique, la tâche interactive et le code interactif...

Lire l’article
PrécédentProchain

Foire aux questions

Qu’est-ce qu’un Data Lakehouse ?

Expand

A Data Lakehouse is a new, open data management architecture that combines the flexibility, cost-efficiency, and scale of data lakes with the data management and ACID transactions of data warehouses, enabling business intelligence (BI) and machine learning (ML) on all data.

How does Ilum simplify Spark on Kubernetes?

Expand

Ilum abstracts the complexity of managing Apache Spark on Kubernetes. It provides a managed control plane that handles cluster provisioning, auto-scaling, and lifecycle management, allowing you to focus on your data and code rather than infrastructure.

What makes Ilum a Modern Data Platform?

Expand

Ilum is a Modern Data Platform because it unifies data lakes and warehouses into a single architecture (Data Lakehouse). It is cloud-native, built on Kubernetes, and supports a wide ecosystem of tools (Spark, Airflow, MLflow), giving you the flexibility and scalability needed for modern data workloads.

Is Ilum really free?

Expand

Yes! Ilum offers a free version that gives you access to the core Data Lakehouse platform. You can deploy it on your own infrastructure (on-premise or cloud) without any licensing fees for the core features.

Can I use Ilum with my existing tools?

Expand

Absolutely. Ilum is built on open standards and integrates seamlessly with popular tools like Jupyter Notebooks, Apache Airflow, and MLflow. It also supports various storage backends including S3, GCS, Azure Blob Storage, and HDFS.

How does Ilum compare to Databricks?

Expand

While Databricks is a powerful commercial platform, Ilum offers a lightweight, flexible, and cost-effective alternative that you can host yourself. Ilum provides a similar unified experience for Spark, Airflow, and MLflow but gives you full control over your infrastructure and data sovereignty.

Contactez-nous

Nous sommes là pour vous aider. Contactez-nous dès aujourd’hui.

Icône d’e-mail[email protected]
Logo d’Ilum

Optimisez les opérations de données avec une vitesse et un contrôle inégalés.

Démarrer